
Nodos de Base de Datos
Camila Escobar · 17 de junio de 2026
Siete nodos leen y escriben tablas del workspace. Son los que usa casi toda automatización, así que los detalles de acá se pagan solos rápido.
Query Rows
Recupera filas de una tabla. Dos modos, y elegir el correcto importa:
Por id de fila — una búsqueda de una sola fila. El más rápido, y el correcto cuando un paso anterior ya te dio el id.
Por filtros — con orden y paginación, para todo lo demás.
La lectura de filas tiene tope por llamada, así que una consulta sin filtro sobre una tabla grande devuelve la primera página y no un error. Filtrá en la consulta. Un flujo que lee todo y descarta la mayoría en un paso posterior ya pagó la lectura, y en una tabla grande se pierde en silencio las filas más allá del tope.
Dos formas que hay que esperar aguas abajo
Una columna de Estado vuelve como el id de su opción, no como su nombre. Comparar un estado con el texto "Aprobado" en un nodo posterior falla sin dar error — compará contra la opción, o ramificá por otra cosa.
Dentro de un nodo Script, las claves de la fila pierden los espacios: Player_Name, no Player Name. Esto es propio de los scripts; los demás nodos y el gateway ven los nombres con espacio.
Insert Rows
Inserta una o muchas filas. Una fila usa un mapa de campos; un lote toma una lista, que puede venir directo de la salida de un paso anterior.
Los ids se generan solos — no los inventes.
Preferí un insert por lote antes que un bucle con un insert adentro. El mismo resultado, una fracción del trabajo.
Update Rows
Actualiza campos de una fila por id, o de muchas por filtro.
La forma con filtro es el filo de toda la categoría: una actualización con un filtro que abarca más de lo que pensabas las actualiza todas, y no hay paso de confirmación. Antes de escribir un update filtrado, pasá ese mismo filtro una vez por un nodo Query Rows y mirá el conteo.
Delete Rows
Borra por id de fila o por filtro, y exige al menos un criterio — no existe el "borrar todo" por omisión.
Aplica la misma precaución que en Update, con menos margen de recuperación. Si el flujo es destructivo y corre sin supervisión, acompañalo con un Table Snapshot.
Aggregate Rows
Agrupa una tabla por una o más columnas y calcula, en una sola consulta, un conteo por grupo más SUM, AVG, MIN, MAX o COUNT opcionales sobre columnas numéricas o de fórmula. Los filtros pueden acotar antes. La salida es una lista de grupos, cada uno con sus valores, su conteo y sus métricas.
Esto existe para que no leas diez mil filas para sumar una columna. Si el trabajo del flujo es "cuántos, por estado" o "total por cliente este mes", esto es un nodo en vez de una consulta, un bucle y un acumulador — y es la diferencia entre un flujo que corre en un segundo y uno que se pasa de tiempo.
Table Snapshot
Toma un checkpoint de todas las filas de una tabla, guardado como blob.
Su propósito es el nodo de abajo. Sacá un snapshot antes de una secuencia riesgosa y tenés a dónde volver.
Table Restore
Restaura una tabla desde un checkpoint. Dos cosas para tener claras:
Es un reemplazo de tabla completa, no una fusión. Todo lo que hay ahora en la tabla se va, y las filas del checkpoint ocupan su lugar. Las filas creadas después del snapshot no se preservan.
Exige una confirmación explícita. Sin ella el nodo falla y no cambia nada — una guarda deliberada, para que una restauración no ocurra porque una plantilla resolvió a algo inesperado.
El patrón para el que están hechos
Table Snapshot ──▶ Try ──▶ trabajo riesgoso ──▶ …
                     └── Catch ──▶ Table Restore
Snapshot, el trabajo dentro de un Try, y la restauración en el Catch. Eso le da a un cambio de datos de varios pasos algo parecido a un comportamiento de todo-o-nada, que los nodos de escritura por separado no ofrecen.
Siguiente
Nodos de lógica — Try/Catch, bucles, ramificación
Lógica del lado del servidor — dónde encajan estos en un flujo real
Corridas y depuración — chequear qué hizo realmente una escritura
Cómo se ve
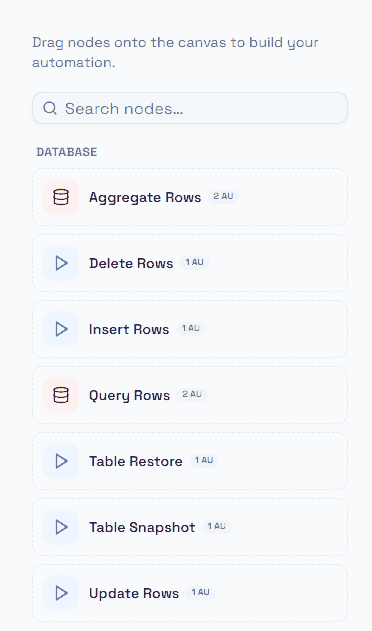
Los siete nodos de base de datos, tal como aparecen en la paleta.
Fíjate en los dos colores de ícono. El ícono rojo de base de datos marca un nodo de consulta — Aggregate Rows y Query Rows leen y devuelven datos. El ícono azul de play marca un nodo de acción — Insert, Update, Delete, Snapshot y Restore cambian algo. Esa distinción no es cosmética: un nodo de consulta puede ir en cualquier parte, un nodo de acción es una escritura de la que respondes tú.
Las insignias de costo también se parten por esa línea: leer cuesta 2 AU, escribir cuesta 1 AU.